Konfidensialitet
Bakgrunn
Lov om offisiell statistikk og Statistisk sentralbyrå (LOV-2019-06-21-32) § 14 (tilgang til opplysninger for statistiske resultater og analyser) ledd (5) sier at «Taushetsplikten etter § 8 gjelder tilsvarende for den som får tilgang til opplysninger». Slike data kan kun utleveres til forskere i godkjente forskningsinstitusjoner og til offentlige myndigheter. Det stilles derfor strenge krav for tilgang til mikrodata, og søknad om tilgang til mikrodata for forskning er en lang prosess. Kriteriene for å søke om tilgang til registerdata for forskning kan du finne på SSBs sider om data til forskning.
Microdata.no er utviklet for å gjøre det mulig å få tilgang til mikrodata fra registre uten å måtte gå gjennom den omstendelige søknadsprosessen det er for å få data utlevert. Men det er en betingelse for en slik forenkling at sikkerheten og konfidensialiteten til mikrodataene er like godt ivaretatt som ved utlevering, helst bedre. Det har derfor fra begynnelsen vært et eksplisitt krav at brukerne ikke skal kunne se mikrodata eller på annen måte være i stand til å avsløre informasjon om enkeltpersoner. Når SSB publiserer offisiell statistikk er det aggregerte data. Likevel må SSB passe på ved ulike typer tiltak at det ikke er mulig å føre informasjon tilbake til enkeltpersoner eller andre typer statistiske enheter som statistikken dreier seg om.
De resultatene som microdata.no produserer for sine brukere, tabeller eller analyser, er i likhet med SSBs statistikk aggregerte data. Men uten begrensninger vil en bruker av microdata.no lett kunne produsere tabeller og andre typer statistiske resultater som SSB ikke ville kunne publisere. For å forhindre at det skjer er det innført flere typer tiltak som skal begrense mulighetene for å kunne avsløre informasjon som skal være konfidensiell.
Dette vedlegget vil beskrive de tiltakene som er implementert for å ivareta konfidensialitet i microdata.no. Tiltakene er basert på scenarier for hvordan konfidensialitet i microdata.no kan angripes eller utilsiktet komme i fare. Disse scenariene vil ikke bli beskrevet. Det vil bli lagt vekt på det som er nødvendig for at brukeren skal kunne forstå tiltakene og forholde seg til de statistiske resultatene på riktig måte.
De tiltakene som er beskrevet nedenfor er de som er implementert så langt. Det vil kunne komme flere tiltak etter hvert eller også justeringer av de tiltakene som er beskrevet nedenfor. Dette vedlegget vil bli oppdatert når det kommer endringer.
Tiltak 1: Minste populasjonsstørrelse
Det er ikke tillatt å definere undersøkelsespopulasjoner med færre enn 1000 personer. Forsøk på å definere slike populasjoner vil bli møtt med en melding av typen

Tiltak 2: Winsorisering
Winsorisering er en teknikk som ofte brukes i analyser for å hindre at ekstreme observasjoner skal få for stor innvirkning på analyseresultatene. Teknikken anvendes på alle numeriske variabler og består i å kutte av fordelingen i begge ender ved bestemte prosentiler. Vi benytter 2% winsorisering som betyr at de 1% høyeste verdiene settes til 99-prosentilen (nedre grenseverdi) og de 1% laveste verdiene settes til 1-prosentilen (øvre grenseverdi). Dette skjer kun ved visning av statistiske resultater, med utgangspunkt i den aktuelle populasjon som statistikken beregnes ut i fra.
Siden fordelingene til mange numeriske statistiske variabler er skjevfordelte, typisk med lange haler i øvre ende (eks. inntekter og formuer), vil winsorisering påvirke gjennomsnitt og standardavvik til en viss grad. Disse målene vil typisk bli estimert for lave. På den andre siden vil medianer, kvartiler og andre prosentiler ikke bli påvirket av winsorisering.
Winsorisering påvirker alle deskriptive statistikker og grafiske visninger for å hindre at de mest ekstreme verdiene blir avslørt.
Eksempler på hhv. histogram og deskriptiv summarize-statistikk med winsorisering:
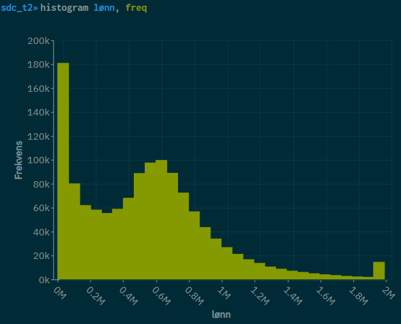
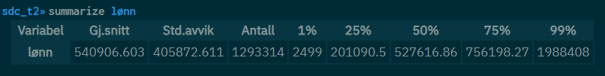
I histogrammet over ser man at de ytterste søylene i hver ende er mye høyere enn nabosøylene. Dette kommer av at hhv. verdiene over/under er satt til den aktuelle grenseverdien, og disse søylene representerer dermed alle enheter med denne grenseverdien eller høyere/lavere. Grenseverdiene oppgis under kolonneheadingene 1% og 99% i summarize-statistikken over.
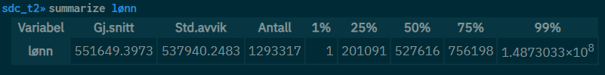
Under vises samme summarize-statistikk uten winsorisering. Merk at 1- og 99-percentilene her er hhv. mye lavere/høyere enn de oppgitte winsoriserte verdiene over (summarize uten anonymiseringsfilteret påskrudd viser de sanne minimums- og maksimumsverdier i stedet for grenseverdier for 1- og 99-percentiler). Merk også at de sanne verdiene for gjennomsnitt og standardavvik under er noe høyere enn i tilfellet over:
Winsorisering ved aggregering av data
Aggregering kan i microdata.no gjøres gjennom kommandoene collapse() og aggregate().
Om man bruker commandoen collapse() til å aggregere et datasett opp til et nivå hvor deskriptiv statistikk winsoriseres, kjøres selve collapse-aggregeringen uten winsorisering. Aggregering fra arbeidsforhold (jobber) til personnivå eller fra person- til familienivå er eksempler på aggregeringer som gjøres uten winsorisering. Bruk av collapse() hvor by()-leddet angir en pseudonymisert variabel winsoriseres altså ikke i selve aggregeringssteget.
Men dersom målenhetstypen til collapse() angitt i by()-leddet er en enhetstype gitt ved en vanlig ikke-pseudonymisert variabel, f.eks. kommune, fylke, næringstype, eller utdanningsnivå, vil beregninger gjort gjennom collapse() bli gjenstand for winsorisering. Grunnen til dette er at disse enhetstypene ikke vil bli winsorisert ved generering av deskriptiv statistikk. Derfor må altså winsoriseringen gjøres i forbindelse med selve aggregeringen.
Resultater som fremstilles gjennom regresjonsanalyser er ikke å betrakte som personidentifiserende informasjon. Ved slike analyser benyttes derfor de underliggende ikke-winsoriserte data. Regresjonsestimater vil derfor ikke bli påvirket av winsorisering.
Tiltak 3: Frekvensstøy
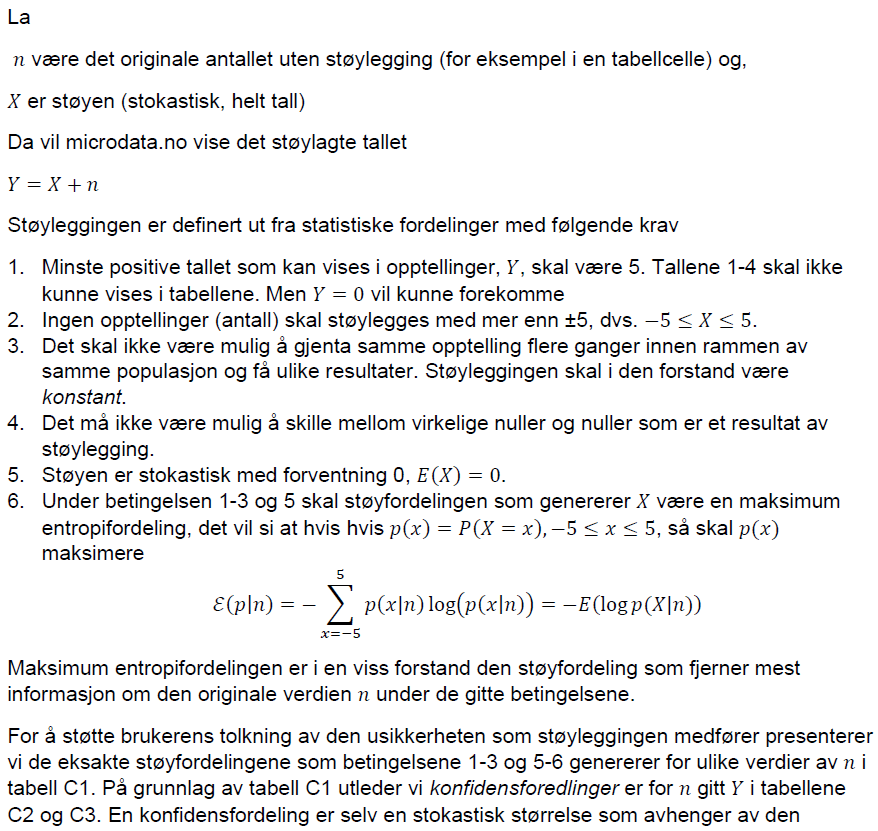
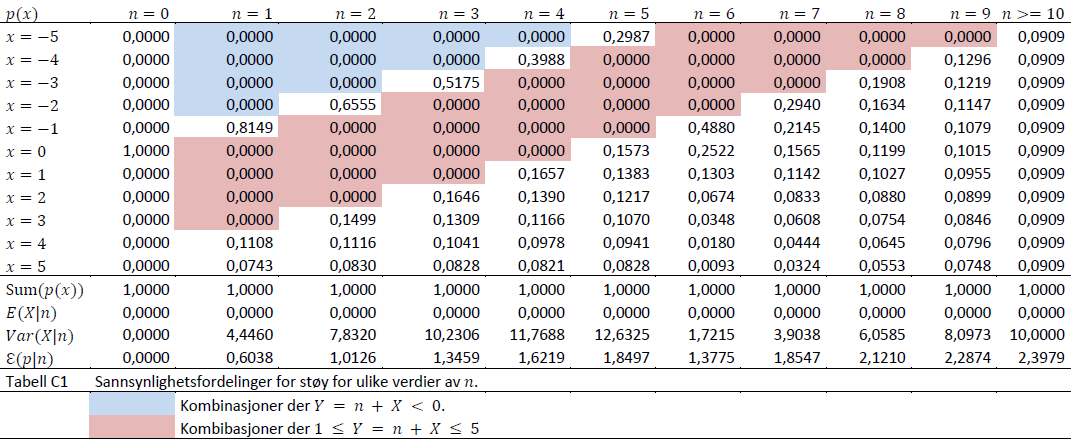
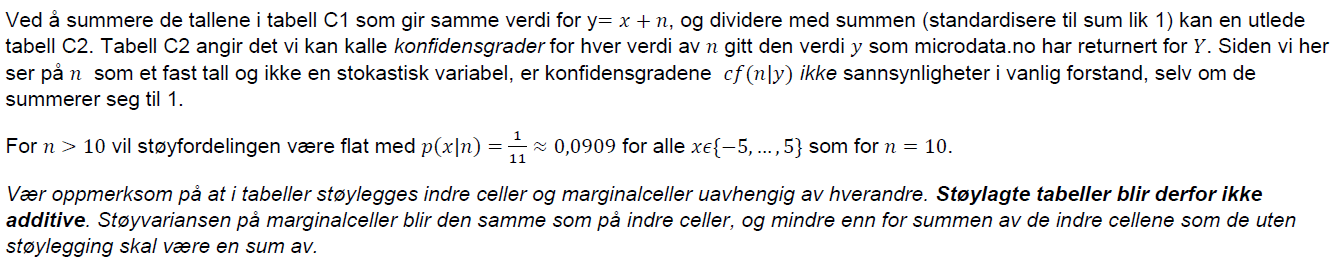
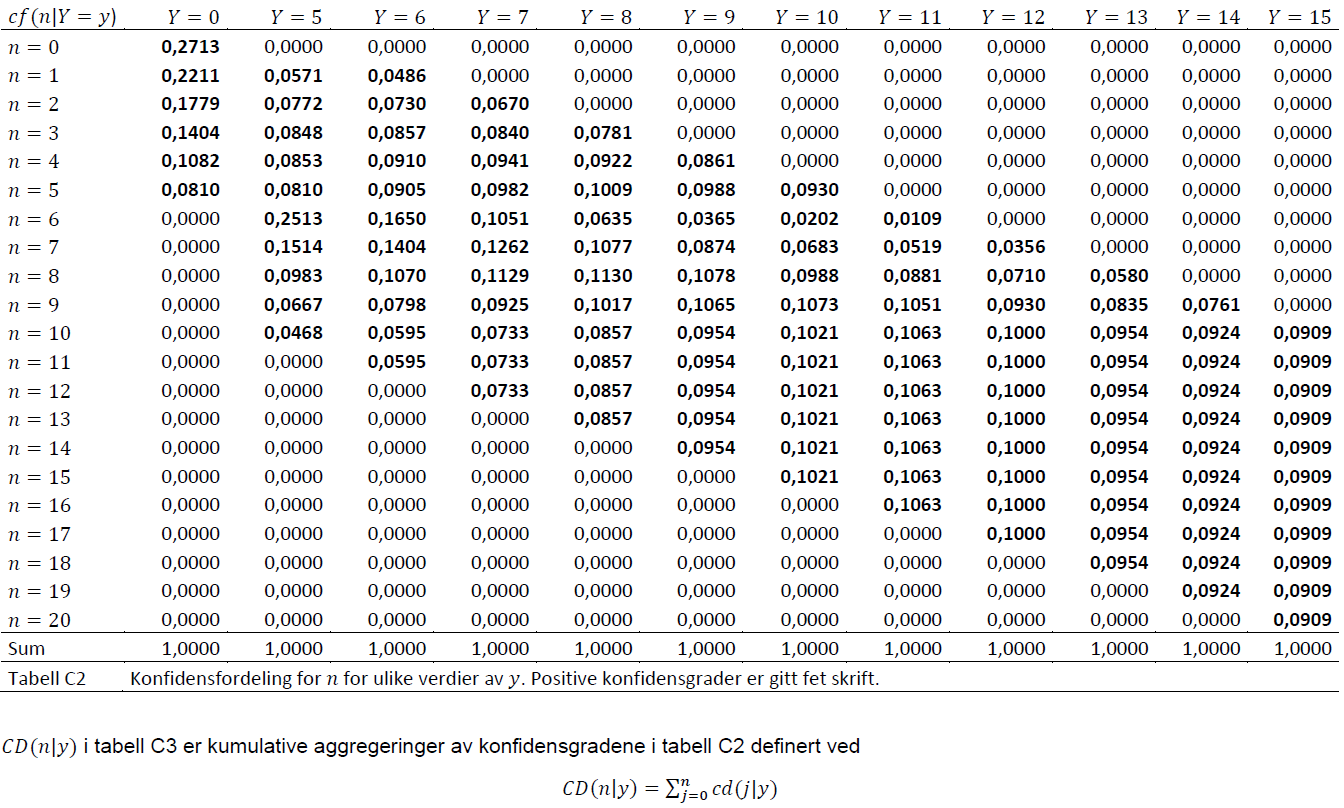
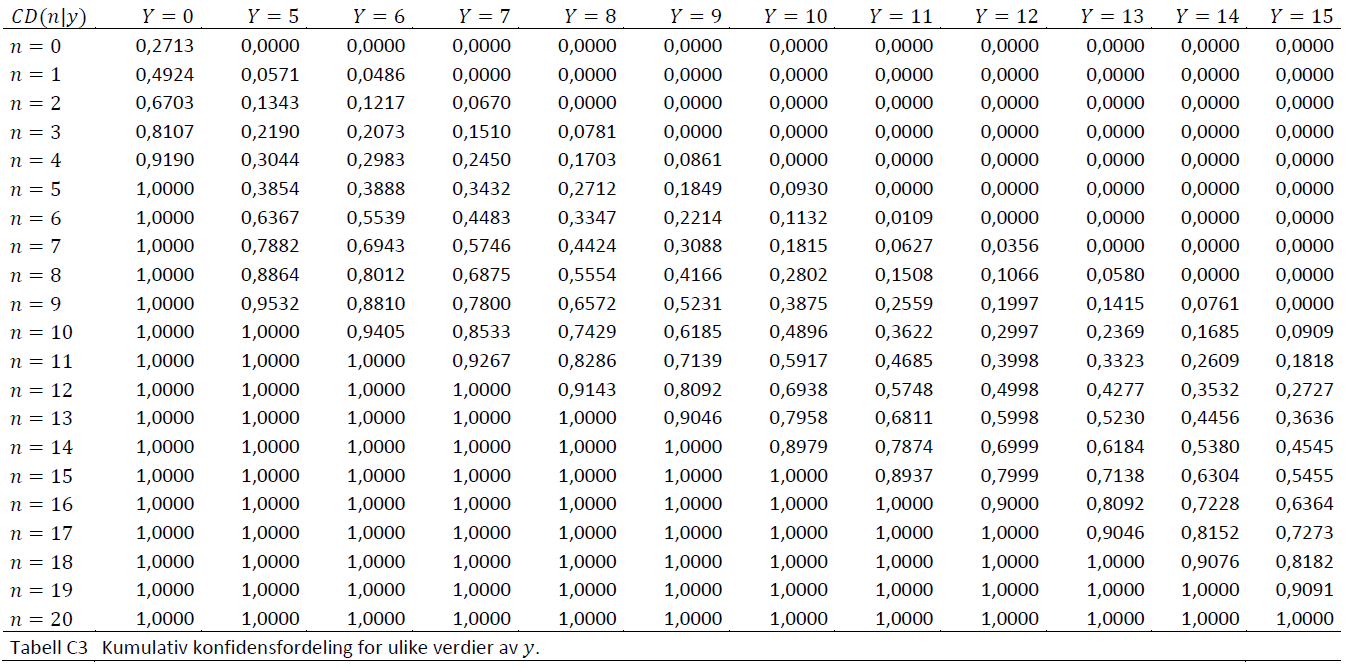
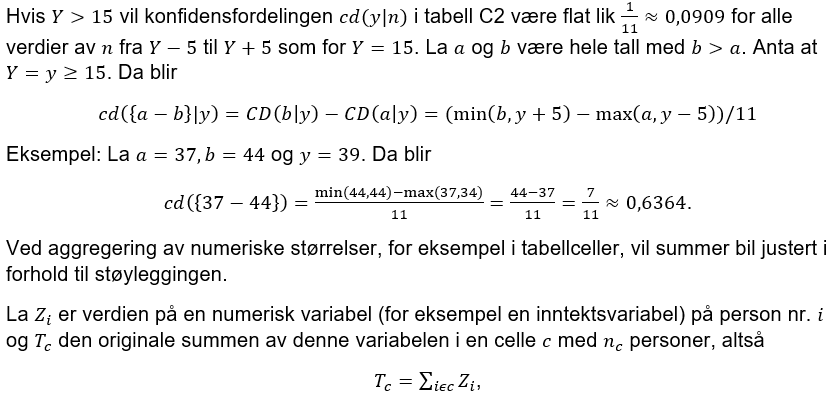
Alle opptellinger av antall enheter i et datasett som vises i forbindelse med diverse operasjoner, eller statistiske opptellinger som vises gjennom blant andre kommandoene tabulate eller summarize blir støylagt med en tilfeldig støy i intervallet -5 til 5. Av ekstra personhensyn støylegges imidlertid ingen tall til verdiene 1-4. Altså vises bare de støylagte verdiene 0 (missing), eller 5 og oppover.
Merk at marginalverdier i en frekvenstabell støylegges uavhengig. Derfor er det ikke så ofte at summen av de indre cellene stemmer over ens med kolonne- eller rekketotalen.
Individene som inngår i en frekvensopptelling avgjør hvordan støyen blir, så dersom samme gruppe individer (f.eks. i en tabellcelle) telles flere ganger i samme type statistikk, skal støyen i utgangspunktet bli den samme.
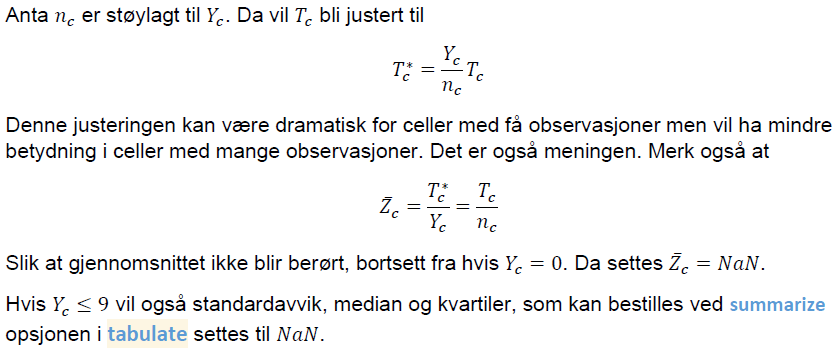
Summer over numeriske statistikkvariabler knyttet til enhetene i en tabellcelle, for eksempel inntekter, er justert proporsjonalt med støyleggingen slik at gjennomsnittstall blir upåvirket. Der hvor støyleggingen resulterer i at antall enheter bak summen blir 0, blir summen satt til 0, og gjennomsnittet som da blir 0/0 blir satt til NaN.


Tiltak 4: Grafiske plott. Hexbinplott
Det er vanlig å bruke spredningsplott for å etablere et visuelt bilde av data eller også vise sammenheng mellom numeriske variabler. Slike plott kan være veldig avslørende, spesielt hvis det er få observasjoner i forhold til det grafiske området og for de punktene i plottet som ligger utenfor hovedmassen av punkter. Hvis du for en enhet/person i populasjonen kjenner verdien på en av de variablene som spenner ut plottet, er det ofte mulig å lese av verdien til den andre variabelen med for stor nøyaktighet.
For å hindre at dette kan skje, foretas en anonymisering av slike plott i microdata.no. For dette formålet er det blitt valgt å fokusere på en teknikk som kalles hexbin-plott. I et hexbin-plott deles det grafiske området inn i regulære sekskanter som fargelegges med sterkere intensitet etter hvor mange observasjoner som befinner seg i hver av dem.
Sekskanter hvor antall observasjoner er under fem vises uten fargelegging.
Eksempel på et hexbin-plott i microdata.no:
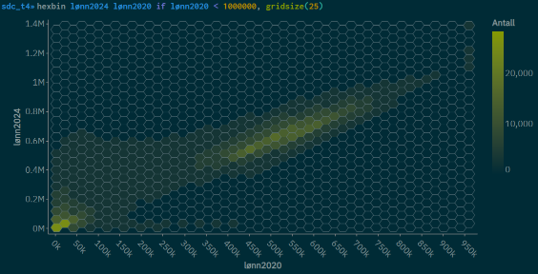
Dersom man ikke klarer seg uten ekte spredningsplott, vil dette tiltaket kunne gi redusert nytteverdi. Men selv med fargelagte arealer som metode å aggregere slike plots, vil man likevel kunne se et klart mønster og danne seg et inntrykk av hvordan sammenhengen mellom de to variablene man måler mot hverandre er.
Tiltak 5: Skjuling av tabeller med for mange lave verdier
Tabeller som lages ved kommandoen tabulate vil i noen tilfeller kunne inneholde mange celler med lave verdier for antallet enheter. Dette kan være problematisk ettersom det gjør det lettere å indirekte identifisere individer ved å studere kombinasjoner av verdier for de
kategoriske variablene som utgjør en tabell. Et annet problem med slike tabeller er at støyleggingen beskrevet under «Tiltak 3» gir en relativt høy usikkerhet for de aktuelle celleverdiene (den prosentvise støyen blir relativt stor ved små tall), slik at den statistiske nytteverdien av tabellen blir lav.
I microdata.no opereres det med en grenseverdi på 50%, dvs. tabeller der mer enn 50% av cellene inneholder frekvensverdier lavere enn 5, vil bli stoppet. I tillegg vil det vises en feilmelding om dette.
Det er mulig å unngå problemet med tabeller som stoppes pga. for mange lave verdier: Ved å lage grovere inndelinger for de kategoriske variablene som utgjør tabellen, eller ved å øke størrelsen på tabellpopulasjonen, vil en kunne øke antallet enheter i hver celle og dermed komme under 50%-grensen slik at tabellen blir godkjent og vises.
Tiltak 6: Ikke tillatt med endringer som påvirker færre enn 10 enheter
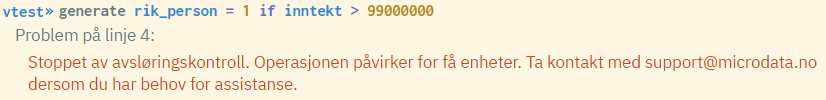
Det er ikke tillatt å gjøre endringer i et datasett som påvirker færre enn 10 enheter, gjennom bruk av kommandoene generate, replace eller recode(). Om dette inntreffer, vil man få en feilmelding og kjøringen vil stoppe.
Det er heller ikke tillatt å gjøre endringer som påvirker alle enheter bortsett fra et antall færre enn 10.
Eksempler:
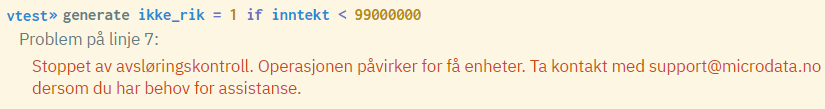
Et viktig unntak er at man kan gjøre endringer som påvirker alle eller ingen enheter.
Eksempler (koden 9999 finnes ikke i datasettet):
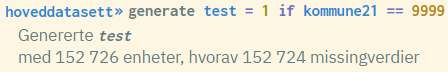
(Merk at antallet missingverdier som rapporteres er ulikt antall enheter i eksempelet over. Dette skyldes støyleggingen av frekvensverdier, jfr. tiltak 3. I praksis vil variabelen test bare inneholde missingverdier.)
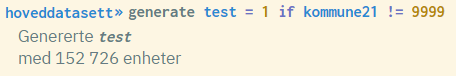
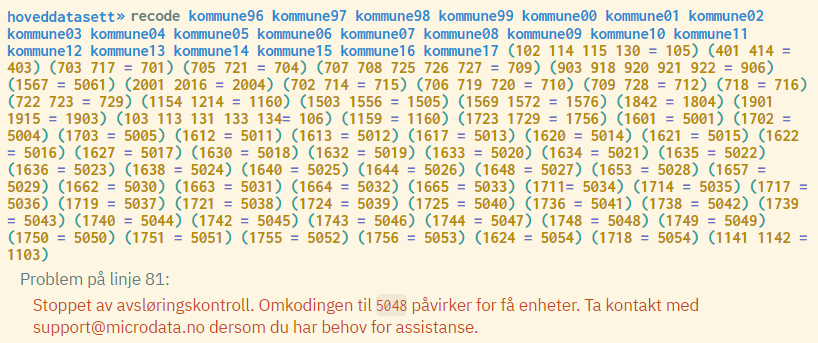
Ved bruk av recode, så gjelder regelen for hvert av omkodingsleddene i uttrykket (man ser på hver av kodene det kodes til, og hvert av leddene må kode om minst 10 observasjoner).
Eksempel:
Tiltak 7: Ikke tillatt med deskriptiv statistikk for populasjoner som utgjør færre enn 10
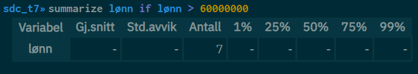
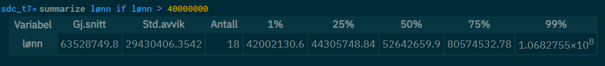
Deskriptiv statistikk gjennom kommandoene summarize, eller summarize i kombinasjon med tabulate (volumtabeller), kan ikke kjøres på populasjoner som utgjør færre enn 10.
Tiltaket kontrollerer at det er minst 10 gyldige verdier i en variabel for at deskriptiv statistikk (gjennomsnitt, standardavvik, etc) skal kunne vises. Grensen var tidligere 9, mens den nå er 10.
Eksempel på deskriptiv statistikk som sensureres (kun antall enheter vises):
Annet eksempel der antall enheter kommer over grensen på 10:
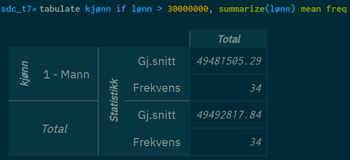
Eksempel på volumtabell som viser gjennomsnittlig lønn fordelt på kjønn, dersom lønn er større enn 30 mill. Her fjernes verdien for kvinner ettersom disse utgjør under 10 enheter for denne aktuelle statistikken. Verdien for menn vises siden de kommer over grensen:
Deskriptiv statistikk knyttet til gjennomsnitt, standardavvik m.m. for grupper av individer under 10 vil ikke være spesielt representativ for generelle populasjoner, og vil derfor ha begrenset allmenngyldig nytteverdi.
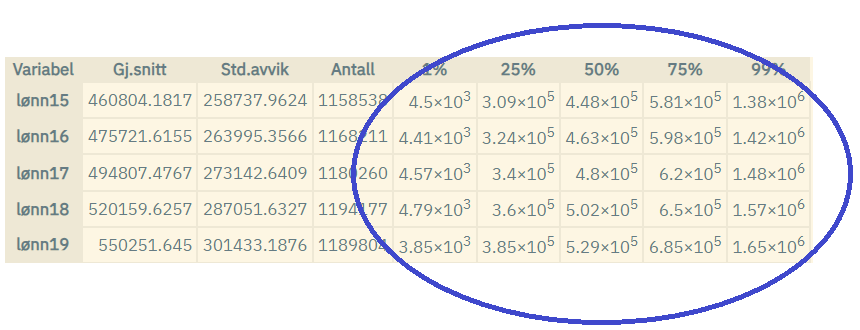
Tiltak 8: Median- og prosentilverdier vises kun med tresifret nøyaktighet Utgått
Historisk beskrivelse (slik tiltaket virket da det var aktivt)
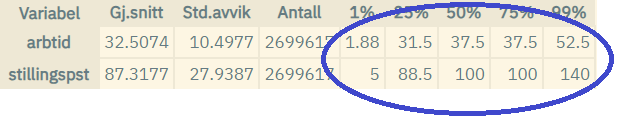
Median- og prosentilverdier viser faktiske verdier som kan knyttes til enkeltpersoner (eller andre enheter). Derfor vises slike verdier kun med tresifret nøyaktighet, og påvirker visningen av tall ved bruk av kommandoene summarize, summarize i kombinasjon med tabulate, og grafer der slike tall inngår.
Eksempler:
Tiltak 9: Konstantledd skjules fra regresjonsresultat dersom analysepopulasjonen har for unike kombinasjoner av kategoriske verdier
For å styrke konfidensialiteten ved regresjonsanalyser, er det en begrensning knyttet til analyser på datasett med for høy grad av unikhet. Hvis kombinasjoner av kategoriske variabelverdier i analysen utgjør veldig små grupper, vil konstantledd-estimatene bli skjult fra regresjonsresultatene. Analysen påvirkes ikke siden konstantleddet inngår i estimeringen.
Det er prinsippet for k-anonymity som benyttes på det underliggende analysedatasettet, definert av populasjonen og settet av forklaringsvariabler for den aktuelle analysen, der grenseverdien er satt til 5. Skjuling av konstantledd skjer altså for regresjoner som kjøres på datasett med færre enn 5 enheter med samme kombinasjon av variabelverdier.
Merk at kontinuerlige variabler inngår ikke ved vurderinger av unikhet, kun kategoriske variabler.
I tilfeller der tiltak 9 slår inn, og man ønsker å se konstantleddet, er det noen grep man kan foreta for å gjøre datasettet mindre unikt (slik at antallet unike kombinasjoner kommer over 5):
- Øke populasjonsstørrelsen
- Bruke grovere inndeling av kategorier
- Begrense antallet kategoriske forklaringsvariabler
Tiltak 10: Mikroaggregering og glatting før beregning av persentiler
Ved beregning av persentiler (inkl. median) gjennomføres det en mikroaggregering av sorterte verdier i grupper av størrelse med 5 i hver gruppe. Alle verdiene i samme gruppe blir erstattet med gjennomsnittsverdien i gruppen. Deretter glattes verdiene med sentrert glidende gjennomsnitt med periode på 5.
Dette tiltaket gjør utslag i alle statistikker som viser persentilverdier. De mest aktuelle er summarize og histogram.
Eksempel på deskriptiv statistikk med mikroaggregering og glatting:
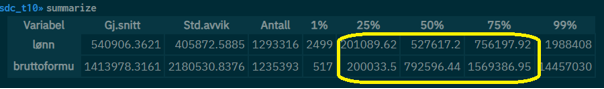
Samme statistikk uten dette tiltaket. Merk at verdiene for de indre persentilene 25%, 50% og 75% endrer seg minimalt. De store avvikene for 1- og 99-percentilene skyldes først og fremst winsoriseringen beskrevet i avsnittet knyttet til tiltak 2 (det er egentlig min- og maks-verdier som vises når anonymiseringsfilteret er avskrudd):
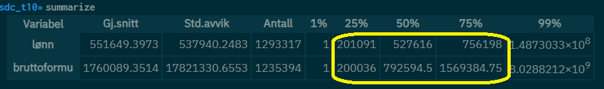
I de fleste tilfeller vil mikroaggregerte og glattede prosentilverdier ha svært lave avvik fra sanne verdier, og vi anser derfor dette som et tiltak som har begrenset innvirkning på analyseresultater. Ved svært lave populasjonsstørrelser vil man imidlertid kunne få et visst avvik fra sanne verdier.